Como usar a ferramenta
- Informe a URL completa HTTP ou HTTPS de uma página pública. Omita credenciais e valores privados de consulta; destinos locais ou restritos não são aceitos.
- Inicie a verificação e leia o status HTTP, a URL final, os sinais noindex e canonical encontrados e a avaliação compatível de robots.txt.
- Compare os resultados com a configuração pretendida. Consulte a inspeção de URL na sua propriedade autorizada do Google Search Console ou Bing Webmaster Tools para obter informações do índice.
Método de cálculo
O servidor consulta a página pública e robots.txt com limites de redirecionamentos, tempo e tamanho. Lê cabeçalhos e tags básicas do HTML original; não executa JavaScript. robots.txt controla o rastreamento; uma regra noindex acessível controla a indexação. A declaração canonical indica uma URL preferida, não a escolha confirmada do buscador.
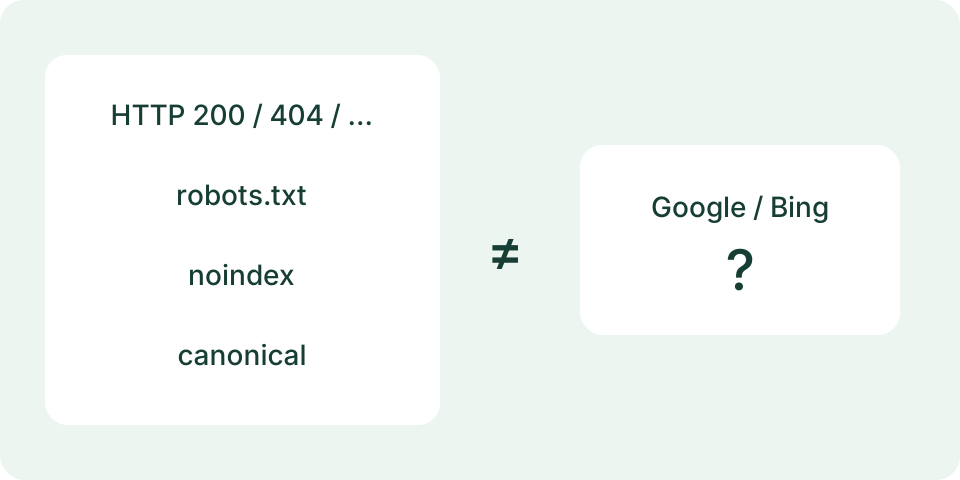
Exemplo de cálculo
Uma página hipotética retorna HTTP 200 e tem uma metatag robots com noindex. A resposta bem-sucedida não cancela essa regra. Retornar 200 sem noindex detectado também não garante indexação.
Confira os sinais de uma página pública
Digite a URL pública HTTP ou HTTPS completa, incluindo o caminho pretendido. Após Iniciar, o Savvy Toolkit obtém a página e informa resposta HTTP final, declarações de robots aceitas, links canônicos e interpretação limitada de robots.txt. Não conecta Search Console ou Bing Webmaster Tools, consulta índices nem envia a página. Um relatório sem bloqueio evidente não confirma indexação. Mantenha essa pergunta separada das observações técnicas públicas mostradas. A ferramenta também não certifica qualidade do conteúdo ou posição nos resultados de busca.
Use uma URL acessível sem login ou credenciais. Destinos privados ou locais, portas personalizadas e protocolos não aceitos são rejeitados. Não cole links de sessão, senhas ou parâmetros confidenciais. A URL chega ao servidor do Savvy Toolkit, que contata o destino público. Sua solicitação se identifica como Savvy ToolkitPublicCheck, não Googlebot. A resposta para esse servidor pode diferir daquela enviada ao navegador ou ao rastreador verdadeiro. Registre essa perspectiva ao comparar observações de fontes diferentes sobre o mesmo endereço.
Comece pela resposta e pelo endereço finais
Compare a URL final com a enviada. O verificador segue uma quantidade limitada de redirecionamentos HTTP, sem apresentar tabela completa de cada salto. Mudanças de host, caminho, protocolo ou barra podem explicar declarações diferentes da página esperada. Limite de redirecionamento, destino não aceito ou falha de solicitação geram indisponibilidade, não uma obtenção bem-sucedida inventada. Parar cancela com as limitações existentes depois que o trabalho alcança o servidor. Essa ação não repara o site nem altera a resposta anterior.
O status final descreve esta solicitação. Uma resposta 200 ainda pode conter erro, estrutura vazia ou conteúdo que não atende à tarefa. Um 404 descreve recurso ausente nessa solicitação, não o estado salvo no índice de um buscador. Examine a resposta e o comportamento pretendido pelo responsável. A ferramenta não atribui nota ao conteúdo, detecta todo soft 404 nem garante possibilidade de ranqueamento pelo código. Preserve sinais distintos antes de decidir o que precisa de correção ou de nova evidência.
Leia declarações sem preencher lacunas
A saída separa o texto do cabeçalho X-Robots-Tag das declarações meta robots, googlebot e bingbot aceitas no head do HTML. São observações, não uma análise completa de todas as diretivas de cada rastreador. Links canônicos encontrados são resolvidos para HTTP ou HTTPS quando possível. Uma declaração ausente não vira instrução positiva de indexação. A ferramenta também não busca o destino canônico para testar seu estado nem determina o canônico escolhido por um mecanismo de busca.
A inspeção HTML é limitada e depende de tipo e codificação compatíveis. Um corpo truncado pode omitir declarações posteriores, e uma resposta não HTML não é inspecionada como HTML. JavaScript não é executado; conteúdo e declarações adicionados depois ficam fora da observação. O resultado explica esses limites. Preserve um valor ausente como ausente e uma inspeção incompleta como incompleta. Nenhuma situação demonstra que a página inteira não possui restrições ou que qualquer rastreador consegue interpretar o mesmo conteúdo.
Separe rastreamento e remoção do índice
robots.txt controla acesso de rastreadores conforme as regras pertinentes. Não é uma instrução confiável para remover uma URL dos resultados. Um rastreador bloqueado não pode ler o noindex da página. Portanto, noindex e Disallow respondem a perguntas diferentes. Confira o objetivo antes de mudar qualquer um. O verificador lê robots.txt na origem da página final, não em um host inicial diferente depois de redirecionamento entre domínios. As regras de uma origem não demonstram o comportamento de outra origem.
A interpretação é conservadora: aceita prefixos literais para Googlebot ou grupo geral, mantendo sintaxe não aceita como desconhecida. Curingas, caminhos escapados ou não ASCII e outros grupos não são avaliados completamente. Neste modelo, robots ausente com 404 ou 410 permite a interpretação limitada de acesso; falhas, conteúdo incompatível e casos não aceitos permanecem desconhecidos. O resultado não simula toda a aplicação de robots por cada buscador nem substitui uma inspeção real feita pelas ferramentas verificadas do proprietário.
Confira dois exemplos de sinais
Imagine resposta HTML final 200 e meta robots com noindex, follow. O 200 indica entrega bem-sucedida da resposta; noindex é uma declaração separada sobre indexação. Encontrar ambos não contradiz HTTP. Confira se a declaração corresponde ao propósito do site. Uma página privada de revisão pode usá-la intencionalmente. Removê-la só faz sentido numa página pública aprovada e não demonstra que o buscador vai manter o conteúdo. A decisão de publicação e a observação técnica precisam continuar separadas.
Agora imagine 200, nenhum noindex observado e decisão de robots desconhecida porque o arquivo usa curingas não aceitos. Isso é evidência incompleta, não uma aprovação total. Um canônico apontando para outra página também precisa ser comparado com a organização de duplicatas pretendida, sem ser declarado automaticamente um erro. Os exemplos são formatos fictícios. O Savvy Toolkit não deduz deles indexação ao vivo, propriedade, utilidade ou escolha do buscador. Guarde as limitações junto aos dados para evitar conclusões que não foram verificadas.
Compare com a inspeção real do proprietário
Para um site que você controla, use as ferramentas verificadas do buscador para consultar estado registrado e evidência de obtenção ao vivo disponível. A Inspeção de URL do Google distingue informação indexada de teste ao vivo; eles podem refletir horários diferentes. O Savvy Toolkit não oferece esses relatórios conectados a contas. Compare a mesma URL e registre horários. Trecho em cache, busca site: e obtenção técnica respondem a perguntas distintas. Não devem ser reunidos como confirmação única de um estado atual.
Investigue divergências começando por URL final, versão publicada, acesso e horário. Compare HTML entregue pelo servidor com a visualização renderizada pertinente quando JavaScript importa. O responsável pode consultar logs de solicitações reais do rastreador sob seu acesso existente. Não remova uma restrição deliberada de privacidade para produzir resultado aparentemente positivo num verificador público. A ferramenta não comprova novo rastreamento nem substituição do estado anterior do buscador. Preserve os contextos distintos durante o diagnóstico antes de qualquer mudança de configuração.
Trate falhas e escolha uma próxima verificação
Uma solicitação ocupada, desativada, esgotada ou não aceita não gera relatório confiável. Registre o estado e repita a mesma URL pública manualmente quando apropriado. Redefinir apaga entrada e relatório; não há monitoramento automático depois do sucesso. A ferramenta não modifica cabeçalhos, robots, canônicos, sitemaps ou conteúdo. Uma falha deste servidor não comprova inacessibilidade mundial e não deve provocar uma mudança sem relação com o problema. Investigue o estado específico antes de editar configurações ou excluir restrições intencionais.
Use a consulta DNS para uma pergunta separada sobre nome público e tipo de registro. DNS válido não garante obtenção HTTP nem indexação. Mantenha um registro breve com URL enviada, URL final, horário, código, declarações e limites da inspeção. Isso ajuda o responsável a investigar uma divergência concreta sem transformar um teste público limitado em veredicto sem evidência sobre busca. As decisões seguintes devem considerar as provas do site e sua intenção de publicação, não apenas a aparência do relatório.
Como interpretar o resultado
O HTML é limitado a 256 KiB e robots.txt a 64 KiB. Regras com curingas não compatíveis, conteúdo incompleto ou falhas de consulta permanecem incertos. Uma tag ausente no HTML analisado pode existir na página renderizada completa. A localização e a identidade da consulta podem receber respostas diferentes das de um rastreador.
Dúvidas comuns
Um resultado favorável comprova indexação no Google?
Não. Os sinais públicos não revelam o estado armazenado no índice nem garantem inclusão futura.
robots.txt remove uma URL da busca?
Uma restrição de rastreamento não é uma regra de remoção do índice. O rastreador bloqueado pode não conseguir ler noindex.