Cómo usar la herramienta
- Introduce la URL completa HTTP o HTTPS de una página pública. Omite credenciales y valores privados de consulta; los destinos locales o restringidos no son compatibles.
- Inicia la comprobación y revisa el estado HTTP, la URL final, las señales noindex y canonical detectadas y la evaluación compatible de robots.txt.
- Compara los hallazgos con la configuración prevista. Consulta la inspección de URLs en tu propiedad autorizada de Google Search Console o Bing Webmaster Tools para conocer los datos del índice.
Método de cálculo
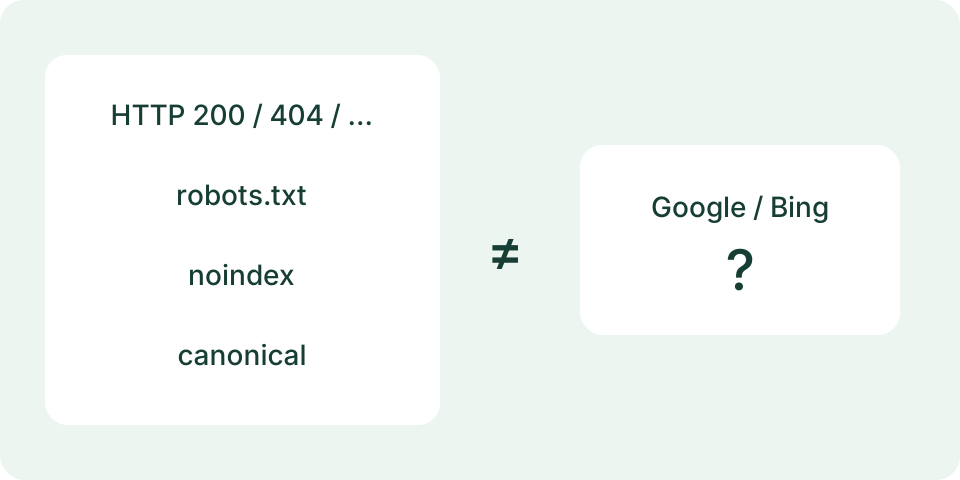
El servidor consulta la página pública y robots.txt con límites de redirecciones, tiempo y tamaño. Lee encabezados y etiquetas básicas del HTML original; no ejecuta JavaScript. robots.txt controla el rastreo y una regla noindex legible controla la indexación. Una declaración canonical indica una URL preferida, no la elección confirmada del buscador.
Ejemplo de cálculo
Una página hipotética devuelve HTTP 200 e incluye una metaetiqueta robots con noindex. La respuesta correcta no anula esa regla. Una respuesta 200 sin noindex detectado tampoco garantiza la indexación.
Comprueba las señales de una página pública
Introduce la URL HTTP o HTTPS completa, con la ruta prevista. Después de Iniciar, Savvy Toolkit obtiene la dirección y muestra respuesta HTTP final, declaraciones de robots admitidas, enlaces canónicos y una interpretación limitada de robots.txt. No conecta con Search Console o Bing Webmaster Tools, consulta índices ni envía la página. Un informe sin un bloqueo evidente no confirma indexación. Mantén esa pregunta separada de las observaciones técnicas públicas mostradas aquí. La herramienta tampoco certifica calidad del contenido ni posiciones en buscadores.
Utiliza una URL que pueda revisarse sin sesión ni credenciales. Se rechazan destinos locales o privados, puertos personalizados y protocolos no admitidos. No pegues enlaces de sesión, contraseñas ni parámetros confidenciales. La URL llega al servidor de Savvy Toolkit, que contacta el destino público. Se identifica como Savvy ToolkitPublicCheck, no como Googlebot. La respuesta a este servidor puede diferir de la enviada al navegador o a un rastreador real del buscador. Registra esa perspectiva cuando compares observaciones de fuentes distintas.
Empieza por la respuesta y dirección finales
Compara la URL final con la enviada. El comprobador sigue una cantidad limitada de redirecciones HTTP y no ofrece una tabla completa de cada salto. Cambios de host, ruta, protocolo o barra pueden explicar declaraciones distintas de la página prevista. Un límite de redirecciones, destino no admitido o fallo de solicitud produce indisponibilidad, no una obtención correcta inventada. Detener cancela con las limitaciones correspondientes una vez que el trabajo llega al servidor. No equivale a reparar el sitio.
El código final describe esta solicitud. Una respuesta 200 puede contener un error, una estructura vacía o contenido que no cumple la tarea. Un 404 indica un recurso ausente para esa solicitud, no informa directamente del estado guardado en el índice del buscador. Revisa la respuesta real y el comportamiento previsto por el propietario. La herramienta no puntúa contenido, detecta todos los soft 404 ni garantiza elegibilidad para posicionar a partir del código. Conserva las señales por separado antes de cambiar algo.
Lee declaraciones sin rellenar los huecos
El resultado separa el texto de la cabecera X-Robots-Tag de las declaraciones meta robots, googlebot y bingbot admitidas en la cabecera HTML. Son observaciones, no un analizador completo de directivas para todos los rastreadores. Los enlaces canónicos encontrados se resuelven a direcciones HTTP o HTTPS cuando es posible. Una declaración ausente no se convierte en instrucción positiva de indexación. Tampoco se obtiene el destino canónico para verificar su respuesta ni se determina el canónico elegido por un motor.
La inspección HTML está limitada y requiere tipo y codificación admitidos. Un cuerpo truncado puede omitir declaraciones posteriores; una respuesta no HTML no se analiza como página HTML. No se ejecuta JavaScript, por lo que contenido y declaraciones añadidos después quedan fuera de la observación. El resultado explica esos límites. Mantén ausente un valor no observado e incompleta una inspección incompleta. Ninguna de esas situaciones demuestra que la página entera carezca de restricciones o sea accesible para cualquier rastreador.
Separa rastreo y eliminación del índice
robots.txt controla acceso de rastreadores según las reglas pertinentes. No es una instrucción fiable para quitar una URL de los resultados. Un rastreador bloqueado no puede leer el noindex de la página. Por tanto, noindex y Disallow responden a preguntas diferentes. Revisa el objetivo antes de modificar cualquiera. El comprobador obtiene robots.txt del origen de la página final, no de un host inicial distinto tras una redirección entre dominios. No toma reglas de un origen como prueba sobre otro.
La interpretación es deliberadamente conservadora: admite prefijos literales de rutas para Googlebot o el grupo general y conserva sintaxis no admitida como desconocida. Comodines, rutas escapadas o no ASCII y otros grupos no se evalúan completamente. Un robots.txt ausente con 404 o 410 permite esta interpretación limitada de acceso; errores, contenido incompatible y casos no admitidos quedan desconocidos. El resultado no simula toda la gestión de robots de cada buscador ni sustituye sus herramientas de inspección verificadas.
Revisa dos ejemplos de señales
Imagina una respuesta HTML final 200 y un meta robots con noindex, follow. El 200 indica entrega de respuesta correcta; noindex es otra declaración sobre indexación. Encontrar ambos no es una contradicción HTTP. Comprueba que la declaración coincide con el propósito del sitio. Una página privada de revisión puede utilizarla intencionadamente. Quitarla solo tiene sentido en una página pública aprobada y no demuestra que el buscador vaya a conservarla. Son decisiones de publicación y observaciones diferentes.
Imagina ahora 200, ningún noindex observado y decisión de robots desconocida porque el archivo utiliza comodines no admitidos. Es prueba incompleta, no permiso confirmado. Un canónico hacia otra página también debe compararse con la gestión de duplicados prevista, no señalarse automáticamente como error. Los ejemplos son formas ficticias de respuestas. Savvy Toolkit no deduce de ellas estado de indexación en directo, propiedad, utilidad del contenido ni elección de un buscador. Guarda las limitaciones con los datos para evitar conclusiones adicionales.
Compara con la inspección real del propietario
Para un sitio que controlas, utiliza herramientas verificadas del buscador para consultar estado registrado y pruebas de obtención en directo disponibles. La Inspección de URLs de Google distingue información indexada de prueba en directo, que pueden corresponder a tiempos distintos. Savvy Toolkit no proporciona ninguno de esos informes conectados. Compara la misma URL y anota las horas. Fragmentos guardados, resultados de site: y obtenciones técnicas responden a preguntas diferentes. No deben combinarse como si todos confirmaran el mismo estado actual.
Ante discrepancias, revisa primero URL final, versión desplegada, controles de acceso y momento. Compara HTML enviado por el servidor con una vista renderizada pertinente cuando intervenga JavaScript. El propietario puede consultar registros de peticiones reales del rastreador bajo su acceso existente. No retires una restricción de privacidad deliberada para mejorar la apariencia de un comprobador público. Esta herramienta no demuestra un nuevo rastreo ni que otra obtención haya sustituido el estado anterior del buscador. Conserva ambos contextos durante el diagnóstico.
Gestiona fallos y elige otra comprobación pertinente
Una solicitud ocupada, desactivada, agotada o no admitida no produce un informe fiable. Anota el estado y repite manualmente la misma URL pública cuando corresponda. Restablecer borra entrada e informe; no hay seguimiento automático. La herramienta no modifica cabeceras, robots, canónicos, sitemaps ni contenido. Un fallo desde este servidor no demuestra inaccesibilidad mundial y no debe provocar un cambio ajeno al problema. Investiga el estado concreto antes de editar la configuración o eliminar una restricción existente.
Utiliza la consulta DNS para otra pregunta sobre un nombre público y un tipo de registro. Una respuesta DNS válida no garantiza obtención HTTP ni indexación. Conserva URL enviada, URL final, hora, código, declaraciones y límites de inspección en un registro breve. Eso ayuda al responsable a investigar una discrepancia concreta sin convertir una comprobación pública limitada en un veredicto sin pruebas sobre el rendimiento en buscadores. Las decisiones posteriores deben basarse en pruebas del sitio y su intención de publicación.
Cómo interpretar el resultado
El HTML se limita a 256 KiB y robots.txt a 64 KiB. Las reglas con comodines no compatibles, el contenido incompleto o las consultas fallidas quedan sin resolver. No encontrar una etiqueta en el HTML revisado no demuestra su ausencia en la página renderizada completa. El servidor puede recibir una respuesta distinta a la del rastreador.
Preguntas habituales
¿Un resultado favorable confirma que Google indexó la página?
No. Las señales públicas no muestran el estado almacenado en el índice ni garantizan una inclusión futura.
¿robots.txt elimina una URL de los resultados?
Restringir el rastreo no equivale a impedir la indexación. El rastreador bloqueado puede no llegar a leer noindex.